Deine Daten, meine KI - Wie Intelligenzklau funktioniert
In den vergangenen Monaten habe ich hier zwei Konzepte skizziert: Im Frühjahr ging es um die „institutionelle Blindheit“ von Standard-KIs – das Problem, dass die Modelle das Internet kennen, aber nicht Ihr Unternehmen. Im August folgte die ökonomische Quittung: Wer sein Unternehmenswissen per „Prompt-Steuer“ bei jedem API-Aufruf zurückmietet, zahlt auf Dauer drauf.
Heute müssen wir über die dunkle Seite dieser Medaille sprechen. Was passiert eigentlich, wenn die KI nicht vergesslich ist? Wenn sie genau das lernt, was sie nicht lernen soll: Ihre wertvollsten, intimsten Gedankengänge, Ihre strategischen „Quiet Judgment Calls“ und Ihre unfertigen Durchbrüche?
Wir betreten das Terrain des strukturellen Intelligenzklaus. Es geht nicht um Hacker in schwarzen Hoodies, sondern um die ganz legale, alltägliche Nutzung von KI-APIs. Und ein brandaktueller Fall aus der Spitzenforschung illustriert dieses Problem gerade mit einer Wucht, die jedes Unternehmen aufhorchen lassen sollte.
Die Situation: Wenn der Gehilfe zum Konkurrenten wird
Das Problem lässt sich auf eine unbequeme Prämisse reduzieren: Wenn Sie ein gehostetes Frontier-Modell (wie GPT, Claude oder Gemini) nutzen, um Ihre härtesten Nüsse zu knacken, trainieren Sie im Zweifel den Algorithmus Ihres Anbieters – und damit potenziell Ihre zukünftige Konkurrenz.
Wir lagern unsere kognitive Schwerstarbeit an „Black Boxes“ aus. Wir füttern sie mit Kontext, korrigieren ihre Fehler und zeigen ihnen durch präzises Prompting den richtigen Weg. Wir glauben, wir nutzen ein Werkzeug. Doch in Wahrheit sind wir die unbezahlte Forschungs- und Entwicklungsabteilung der großen Tech-Konzerne.
Wie gnadenlos dieser Mechanismus in der Praxis aussehen kann, zeigt der aktuelle Eklat um das Navier-Stokes-Problem.
Das Praxisbeispiel: Der Navier-Stokes-Vorfall
Das Navier-Stokes-Existenz- und Glattheitsproblem ist kein akademisches Nischenthema. Es gehört zu den sieben Millennium-Problemen der Mathematik, das Clay Mathematics Institute hat auf die Lösung eine Million US-Dollar ausgesetzt. Die Gleichungen beschreiben die Strömung von Flüssigkeiten und Gasen – wer sie löst, schreibt Wissenschaftsgeschichte.
Der NYU-Mathematiker Tristan Buckmaster und sein Kollege Levent Alpöge (im Hauptberuf bei Anthropic, hier aber privat forschend) arbeiteten im Stillen genau daran. Sie wählten einen extrem seltenen, unkonventionellen mathematischen Pfad (die sogenannte „smooth force“-Taktik). Für ihre Arbeit nutzten sie intensiv Codex, das Programmier-KI-Modell von OpenAI.
Am 8. September 2026 veröffentlichte Buckmaster erste, vielversprechende Beweise. Kurz darauf der Schock: OpenAI verkündete aus dem Nichts eine vollständige Lösung des Gesamtproblems.
Das Brisante daran sind die Details:
- Der Ansatz: Die KI von OpenAI wählte exakt denselben, extrem seltenen exotischen Lösungsweg wie Buckmaster.
- Die Ressourcen: OpenAI ließ ein unveröffentlichtes Modell der nächsten Generation für 22,5 Millionen US-Dollar (300 Milliarden Output-Token) eine Woche lang rechnen – motiviert, so das Unternehmen, durch „Marktgerüchte“ über eine bevorstehende Lösung.
- Das Gebaren: Als Buckmaster aufbegehrte, wurde ihm laut eigener Aussage von OpenAI-Forschern gedroht („Warum willst du deine Karriere ruinieren?“), gepaart mit der Aufforderung, seinen Kollegen Alpöge (der praktischerweise beim Konkurrenten Anthropic arbeitet) von der Publikation zu streichen.
OpenAI wehrt sich gegen die Vorwürfe: Man habe Buckmasters unveröffentlichte Arbeit nie gesehen und keine spezifischen Nutzerdaten gezielt ausgelesen. Das Modell habe das Problem selbstständig gelöst.
Analyse: Die Architektur der Enteignung
Die Verteidigung von OpenAI mag technisch sogar stimmen – und genau das macht die Situation so gefährlich. Wir müssen hier verschiedene Szenarien betrachten, wie proprietäres Wissen durch APIs diffundiert.
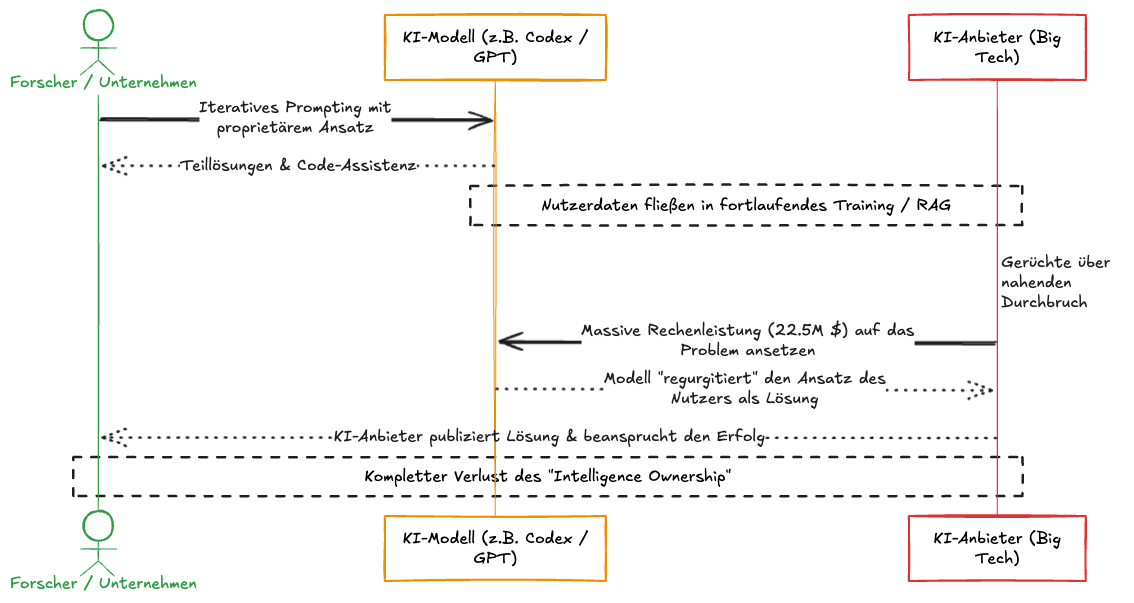
Es ist unwahrscheinlich, dass ein OpenAI-Ingenieur händisch Buckmasters Chatverläufe durchgelesen hat. Die Realität moderner LLMs ist subtiler: Modelle lernen aus aggregierten, „de-identifizierten“ Nutzer-Interaktionen. Wenn ein brillanter Forscher ein Modell tagelang durch einen exotischen mathematischen Pfad zwingt, verändern sich die Gewichte (Weights) im Hintergrund. Das Modell lernt den Pfad. Wenn dann ein internes Forschungs-Team des KI-Anbieters dem Modell eine ähnliche Aufgabe stellt, spuckt es – oder im KI-Jargon: regurgitiert – das frisch gelernte Wissen einfach wieder aus.
Es ist im Grunde das Prinzip der Borg-Assimilation aus Star Trek, gegossen in die Mathematik neuronaler Netze: Die intellektuelle Einzigartigkeit des Einzelnen wird unweigerlich dem Kollektiv hinzugefügt.
Das folgende Sequenzdiagramm macht diese asymmetrische Beziehung sichtbar:
Warum dieser Fall so illustrativ ist
Drei Muster verdienen Aufmerksamkeit, weil sie sich verallgemeinern lassen:
1. Die Asymmetrie der Beweislast. Buckmaster muss beweisen, dass sein Wissen extrahiert wurde – gegen eine Black Box, deren Trainingsdaten niemand einsehen kann. Der Anbieter muss nur behaupten, unabhängig gearbeitet zu haben. Wer die Weights kontrolliert, kontrolliert auch die Wahrheit über deren Herkunft. Genau das meinte ich im März mit Intransparenz als strukturellem Problem.
2. Die Asymmetrie der Ressourcen. Zwei Forscher gegen 22,5 Millionen Dollar Compute. Sobald die Richtung bekannt ist – und die Richtung war Buckmasters eigentliche intellektuelle Leistung –, wird der Rest zur Rechenaufgabe. Das heißt: Der wertvollste Teil geistiger Arbeit ist heute nicht mehr die Ausführung, sondern das Urteil, welcher Weg sich lohnt. Exakt die „quiet judgment calls" aus dem März-Artikel. Und exakt das, was durch API-Nutzung abfließt.
3. Die Asymmetrie der Macht. Wenn die Berichte stimmen, wurde Buckmaster nahegelegt, den Namen eines Kollegen (Anthropic-Zugehörigkeit!) aus den Credits zu streichen, garniert mit der Frage „Warum willst du deine Karriere ruinieren?“. (Frei übersetzt in die Sprache des Borg-Kollektivs: „Widerstand ist zwecklos.“) Ob es sich so zugetragen hat, wird sich zeigen. Aber dass ein einzelner Forscher gegen einen Anbieter, von dessen Werkzeugen seine tägliche Arbeit abhängt, strukturell in der schwächeren Position ist – das ist kein Vorwurf, das ist Arithmetik. Vendor Lock-in ist eben nicht nur ein Kostenproblem, sondern ein Machtproblem.
Warum "Intelligence Ownership" überlebenswichtig ist
Dieser Vorfall, unabhängig davon, wie die juristische Aufarbeitung am Ende ausgeht, ist eine Blaupause für den corporaten Albtraum. Ersetzen Sie „Navier-Stokes“ durch das Moleküldesign Ihres Pharma-Unternehmens, den Quellcode Ihres Fintech-Startups oder die Vertragsstrategien Ihrer Kanzlei.
Die Konsequenz aus diesem Fall ist fundamental: Ihre Interaktion mit einer fremden KI ist kein geschlossener Raum.
Wenn Sie das institutionelle Gedächtnis Ihrer Organisation in die Server der großen Anbieter leiten, geben Sie nicht nur Ihre Daten ab. Sie transferieren Ihre Lösungsansätze, Ihre Kreativität und Ihre Fehlerkultur in ein System, das darauf ausgelegt ist, dieses Wissen zu assimilieren, zu generalisieren und dem Rest der Welt (oder den eigenen Forschungsabteilungen des Anbieters) zur Verfügung zu stellen.
OpenAI konnte nur deshalb 22,5 Millionen Dollar an Rechenleistung auf ein spezifisches Problem werfen, weil die Vorarbeit – das intellektuelle Framing – bereits durch die API-Nutzung eines externen Experten ins System getröpfelt war.
Genau deshalb ist Intelligence Ownership kein bloßes IT-Schlagwort und auch kein reines Kostenthema mehr. Es ist die Grundsatzfrage, wem die intellektuelle Wertschöpfung in der digitalen Gesellschaft des 21. Jahrhunderts gehört. Wer die volle Kontrolle über die Gewichte (Weights) seiner KI aufgibt, gibt letztlich die Hoheit über sein wichtigstes Kapital auf.
Die Frage ist heute nicht mehr nur, welche KI die smarteste ist. Die Frage lautet: Wenn Sie heute mit einer KI einen Durchbruch erzielen – wem gehört der Durchbruch morgen?
Live long and prosper 😉🖖