Revolut steigt aus der Prompt-Tax aus
Statt Claude-Abo ein eigenes Open-Weights-Modell auf 56 GPUs – laut Revolut rund 90 Prozent weniger Inferenzkosten fürs Coding.
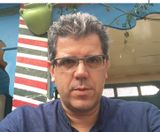
Revolut hat seine KI-Coding-Inferenz von kommerziellen Diensten wie Claude Code auf ein selbst gehostetes GLM-Modell umgezogen – betrieben auf 56 Nvidia B200, für rund 2.000 Engineers. Die Kosten sollen in weniger als einem Jahr um etwa 90 Prozent gesunken sein. Alle Zahlen stammen aus einem Konferenz-Talk von Revolut, nicht aus einer unabhängigen Prüfung.
Für mich ist das der Prompt-Tax-Fall wie aus dem Lehrbuch: Wer genug Volumen hat, hört irgendwann auf, Intelligenz pro Token zurückzumieten, und baut sie selbst. Interessant ist, was trotzdem bleibt – Bildanfragen gehen weiter an fremde Modelle, weil GLM nur Text kann. Intelligence Ownership heißt also nicht Autarkie, sondern bewusst entscheiden, welche Abhängigkeit man behält.
Und eine Bank, die das vorrechnet, nimmt dem Argument „zu komplex für uns" ziemlich viel Luft.
 Tobias Mann
Live long and prosper 😉🖖