L'ère du zettaoctet : quand la croissance exponentielle des données met notre société à l'épreuve
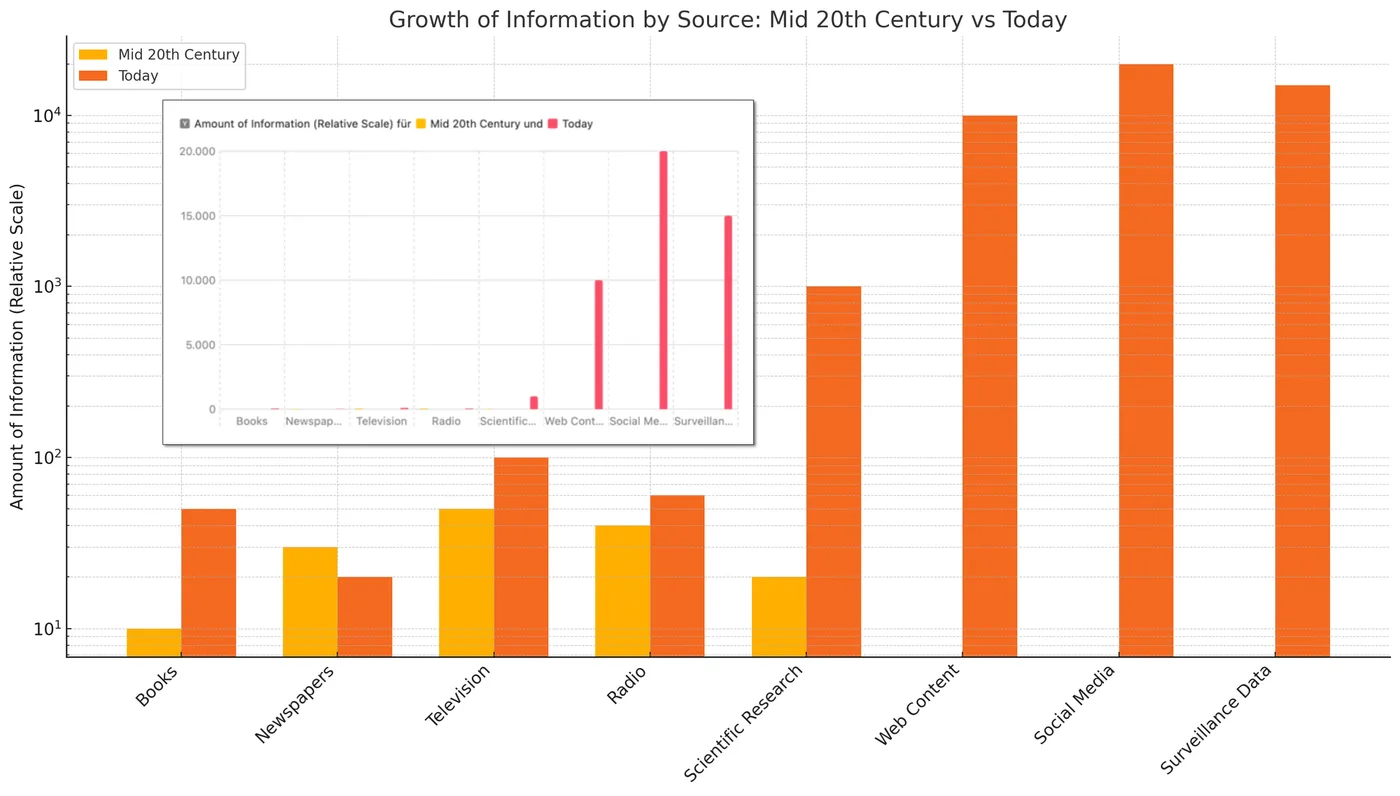
En cinq décennies, le volume mondial de données s'est multiplié à un rythme sans précédent. Ce qui a commencé dans les années 1970 avec des mégaoctets et des gigaoctets est devenu une véritable explosion : le volume global de données a crû de façon exponentielle (jetez un œil à l'axe des ordonnées du graphique ci-dessous 😉). Selon les prévisions, le volume de données générées dans le monde atteindra environ 394 zettaoctets en 2028. Un chiffre que l'esprit humain peine à se représenter.
Un zettaoctet, c'est quoi ?
Un zettaoctet correspond à un trilliard d'octets, soit un nombre à 21 zéros (à titre de comparaison, un gigaoctet en compte 9). Ces quantités gigantesques naissent de la numérisation de tous les domaines de la vie, des réseaux sociaux aux installations industrielles en passant par les mesures scientifiques*.
Écrasés sous les données
Face à cette croissance exponentielle, entreprises, institutions et particuliers se retrouvent devant un défi colossal : de plus en plus de personnes et d'organisations se sentent littéralement écrasées par la masse de données. Plus de la moitié des entreprises déclarent que leur volume de données augmente si vite qu'elles ont du mal à suivre. Gérer, stocker et analyser ces montagnes de données devient toujours plus complexe et gourmand en ressources.
Le casse-tête des données non structurées
Le problème s'aggrave encore du fait que l'essentiel de ces données n'est pas structuré : selon les estimations, environ 80 à 90 % de toutes les données d'entreprise se présentent sous forme non structurée. E-mails, images, vidéos, relevés de capteurs, historiques de chat et bien d'autres choses encore. Ces données ne se rangent pas sagement dans des bases classiques comme mySQL, Oracle ou Postgres, et les méthodes traditionnelles peinent à les fouiller, à les analyser ou à en faire quelque chose d'utile. Le constat est simple : malgré des investissements informatiques colossaux, beaucoup d'entreprises ont déjà du mal à gérer cette montagne de données, alors en tirer de la valeur…
L'un des plus grands défis de notre époque
La croissance exponentielle des données et la domination des données non structurées constituent l'un des plus grands défis sociétaux du moment. La technique et l'espace de stockage ne sont qu'une partie de l'équation. L'enjeu, c'est la capacité à extraire de ce déluge des connaissances précieuses, ou tout simplement justes, à faire avancer l'innovation, tout en garantissant protection des données, sécurité et durabilité. Beaucoup de gens sont dépassés par ce flot et se réfugient dans des bulles où ils cherchent un petit morceau de « Digital Wellbeing », peu importe la qualité et l'exactitude des informations qu'ils y trouvent. On en voit déjà très clairement les effets politiques : ces bulles déforment le sens des réalités de ceux qui y vivent.
Avec les LLM, nous avons enfin une technologie qui s'attaque à ce problème.
Les Large Language Models (LLM), qui sont à la base des outils d'IA actuels comme ChatGPT ou Gemini, représentent une percée décisive dans le traitement de la masse exponentielle de données non structurées. Là où les méthodes informatiques classiques butent souvent sur leurs limites, les LLM offrent pour la première fois des outils capables de traiter efficacement et intelligemment de grands volumes de données non structurées.
Les LLM sont spécialisés dans la compréhension, l'analyse et la génération du langage naturel. Entraînés sur des milliards d'exemples de textes, ils sont capables de repérer des motifs, des liens et du sens, même dans des données textuelles complexes et hétérogènes. Cela permet de fouiller, classer, extraire et interpréter automatiquement des données non structurées comme des e-mails, des posts sur les réseaux sociaux, des rapports ou des articles scientifiques.
Concrètement, les LLM peuvent :
- transformer des données textuelles et multimédias en informations structurées, par exemple en repérant et en extrayant des entités, des thèmes ou des sentiments ;
- filtrer les informations pertinentes dans de grandes masses de données et rendre ainsi le déluge d'informations maîtrisable ;
- rassembler et analyser différents médias, sources et formats de données, ce que les méthodes classiques ne permettent souvent pas ;
- comprendre les liens sémantiques, et donc saisir le contexte et le sens des textes, un avantage décisif pour analyser des données non structurées.
Les LLM ouvrent ainsi, pour la première fois, la possibilité de tirer un savoir précieux de cette masse écrasante de données non structurées et de les mettre au service des décisions, de l'innovation et de l'automatisation. Ils sont donc un outil central pour relever le plus grand défi de la société numérique.
Mais les LLM sont eux-mêmes des « accélérateurs de données »
Paradoxalement, les grands modèles de langage (LLM) comme ChatGPT ou les générateurs d'images comme Midjourney contribuent eux aussi au problème du zettaoctet. D'un côté, ils nous aident à mieux traiter les données non structurées. De l'autre, ils accélèrent de façon spectaculaire la production de nouveaux contenus. En quelques secondes, l'IA produit automatiquement des textes, des images, des vidéos ou des voix synthétiques, qui sont à leur tour stockés, partagés et archivés. Le volume de données ne se multiplie donc plus seulement par la main de l'homme, mais de plus en plus par celle des machines. Nous voilà face à une avalanche de données qui s'accélère toute seule. Autre effet secondaire intéressant : nous aurons bientôt plus de « machine content » que de « human content ». Ce que cela signifie pour les LLM quand on les nourrit avec leurs propres contenus n'est pas encore tout à fait clair.
Cela dit : « Ce qui compte, c'est le trou, pas la perceuse » – revenir à la vraie valeur des données
Dans ce débat, il ne faut jamais confondre la perceuse et le trou. C'est un exemple classique du principe : « Les gens ne veulent pas un produit, ils veulent le résultat. » Ou, comme l'a formulé le professeur de Harvard Theodore Levitt : “People don’t want to buy a drill. They want a hole in the wall.”
Appliqué au problème du zettaoctet : nous collectons, stockons et produisons toujours plus de données. Or la finalité, ce n'est pas la quantité elle-même. Ce qu'on cherche à en tirer, ce sont de meilleures décisions, des connaissances ou des expériences. Si nous nous focalisons trop sur la simple accumulation de données (la « perceuse »), nous perdons facilement de vue l'essentiel : le « trou », c'est-à-dire l'utilité que nous tirons des données.
Dans ce contexte, la distinction entre quantité et qualité des données est décisive. Celui qui amasse un maximum de données sans se soucier de leur pertinence, de leur fiabilité ou de leur contexte risque de se noyer dans un océan d'insignifiances. Car un mauvais trésor de données est souvent pire que pas de trésor du tout. Les plus grosses montagnes de données ne créent pas de valeur réelle en soi. Cette valeur vient des informations précises et bien préparées qui nous aident à atteindre notre but plus vite et plus sûrement, autrement dit, le fameux trou dans le mur.
Et nous voici arrivés au cliffhanger de cette newsletter : que sont des « informations précises, bien préparées et exploitables » ? Eh bien… stay tuned ;)
Live long and prosper 😉🖖