Dans l'un de mes premiers articles sur ce blog, Episode 10.2 - Fishing knowledge in a sea of words without drowning in it 🙂, je terminais sur cette question : si ce qui compte n'est pas la quantité brute de données (la « perceuse ») mais le gain concret de connaissance (le « trou dans le mur »), qu'est-ce qu'une information précise et exploitable, et comment pouvons-nous la produire pour nous-mêmes ?
Le concept de « Second Brain » (deuxième cerveau), issu de la gestion des connaissances personnelles (Personal Knowledge Management, ou PKM), offre une réponse prometteuse à ce déluge d'informations.
De la fiche bristol au réseau numérique : Zettelkasten et Second Brain
Le terme « Second Brain » désigne une démarche systématique pour collecter, organiser et retrouver ses connaissances personnelles. L'idée de fond n'a pourtant rien de nouveau. On peut la voir comme le prolongement moderne et numérique du principe classique du « Zettelkasten », popularisé avant tout par le sociologue Niklas Luhmann.
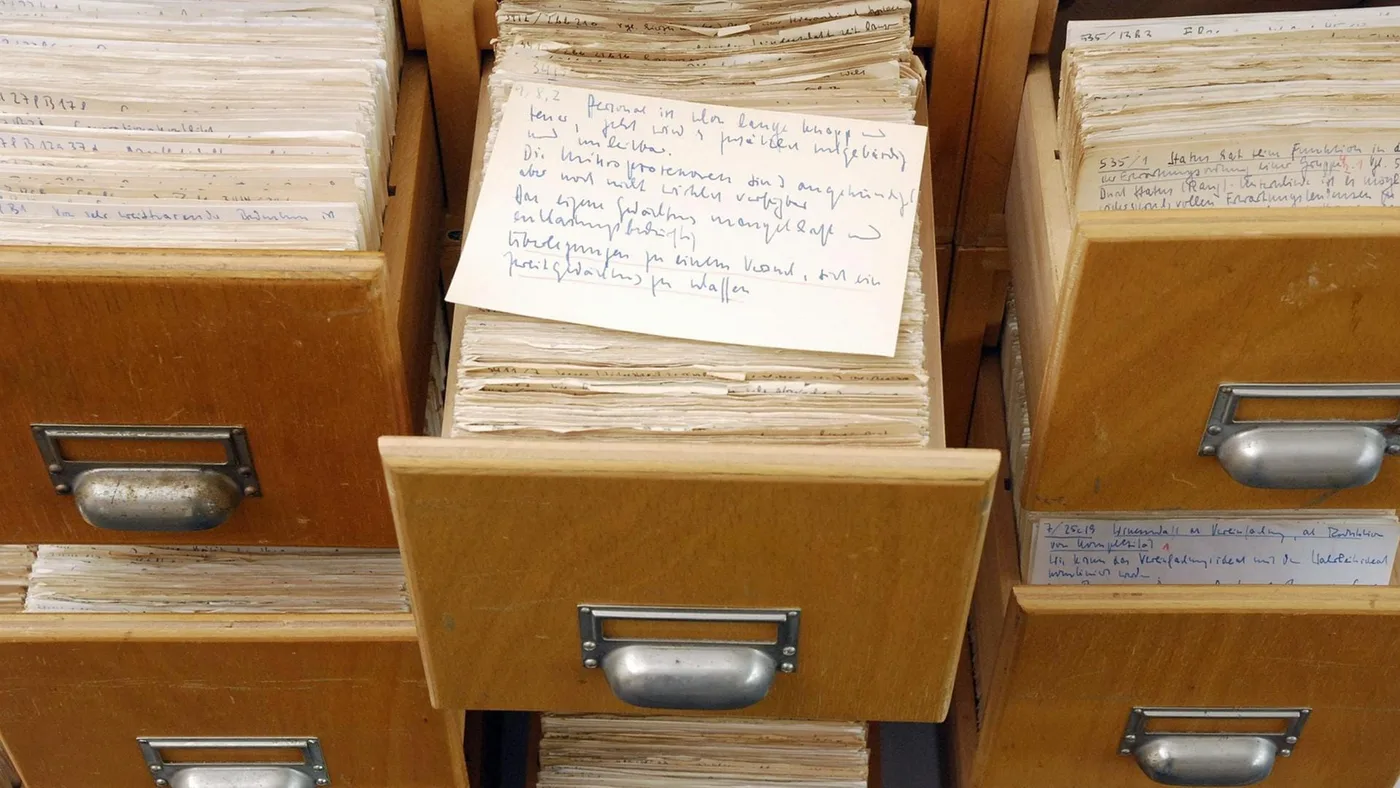
Luhmann consignait ses réflexions et ses notes de lecture sur des fiches cartonnées, qu'il reliait entre elles grâce à un système de numérotation ingénieux. Son objectif : faire apparaître des liens entre des domaines totalement différents.
Le Second Brain transpose cette approche dans le monde numérique. Les deux concepts partagent une ambition centrale : ne pas servir d'ouvrage de référence figé, mais de réseau d'idées en croissance, où l'information est rangée et reliée de façon à soutenir plus tard notre propre manière de penser, d'écrire et de décider.
La base : externaliser l'information
L'idée d'un Second Brain est assez pragmatique. Notre cerveau biologique excelle à reconnaître des motifs, à comprendre des concepts et à faire preuve de créativité. Il atteint en revanche ses limites quand il s'agit de stocker durablement, et sans erreur, de grandes quantités d'informations non structurées.
Un Second Brain délègue cette fonction de stockage à des outils numériques. On y rassemble des favoris, des articles, des notes de réunion ou ses propres idées. On obtient ainsi d'abord un lieu central pour tout ce qui nous semble important.
Les limites de la simple collecte
C'est souvent là que naît un malentendu conceptuel. Une simple collection de données, aussi bien structurée soit-elle, ne suffit généralement pas à créer une vraie valeur ajoutée. Une archive, à elle seule, n'est pas encore un « cerveau ». Si nous nous contentons de ranger de l'information, nous pratiquons au fond une forme d'accumulation structurée de données.
Pour faire d'un système de PKM un véritable Second Brain, il faut une autre composante, décisive : la couche de traitement des données. Il faut des mécanismes qui aident à « distiller », au moment exact où on en a besoin, l'information pertinente à partir de la masse brute collectée.
L'IA comme couche de traitement
On tient ici un cas d'usage particulièrement pertinent pour l'intelligence artificielle. Tandis que le PKM constitue la couche de stockage, les outils d'IA peuvent prendre en charge le traitement actif.
Il y a peu encore, construire une telle couche de traitement aurait exigé de solides compétences en programmation. Il aurait fallu écrire des requêtes de base de données ou coder des algorithmes de recherche pour filtrer intelligemment ses propres notes. Aujourd'hui, les environnements de développement et agents modernes assistés par l'IA, comme Claude Code, ouvrent des voies bien plus accessibles.
Des « logiques de distillation » en langage naturel
Ces outils permettent de créer des « logiques de distillation » spécifiques pour extraire de ses propres collections de données les informations recherchées. Le changement de paradigme, sur le plan didactique, est le suivant : il n'est plus indispensable de savoir programmer au sens classique.
Il suffit le plus souvent de formuler ces logiques avec précision sous forme de texte, c'est-à-dire en langage naturel. On peut par exemple décrire au système :
« Parcours mes notes du mois dernier, relève tous les passages qui traitent d'éthique des technologies et résume les trois arguments les plus fréquemment cités. »
L'IA traduit ces instructions textuelles en scripts exécutables ou en recherches, les applique à la collection de données locale et restitue la connaissance distillée, là encore sous forme de texte.
Conclusion : optimiser le processus du « Knowledge Worker »
Un Second Brain ne naît donc souvent que de la combinaison d'une collection de données bien entretenue et d'une couche de traitement intelligente, pilotable par le langage. Cette approche offre une méthode très concrète pour donner plus de valeur à ses propres données non structurées.
Nous nous rapprochons ainsi, à l'échelle personnelle, d'une solution adaptée à l'ère du zettaoctet : nous nous dotons d'un système qui permet de pêcher, dans l'océan des mots, précisément les informations dont nous avons besoin, sans nous noyer dans la masse des données.
Collectionneur de données invétéré, j'ai passé l'année dernière à affiner cette méthode. Dans de prochains articles, je présenterai ma démarche et montrerai comment j'ai construit mon « Second Brain ».