Ces derniers mois, j'ai esquissé ici deux concepts. Au printemps, il était question de la « cécité institutionnelle » des IA standard : ces modèles connaissent Internet, mais pas votre entreprise. En août est arrivée la facture économique. Qui reloue le savoir de son entreprise à chaque appel d'API, via une « taxe sur les prompts », finit par y laisser des plumes.
Aujourd'hui, il faut parler de l'envers de la médaille. Que se passe-t-il lorsque l'IA n'est pas amnésique ? Lorsqu'elle apprend précisément ce qu'elle n'est pas censée apprendre : vos raisonnements les plus précieux et les plus intimes, vos « quiet judgment calls » stratégiques, vos percées encore inachevées ?
Bienvenue sur le terrain du vol structurel d'intelligence. Pas de hackers en sweat à capuche noir ici : le sujet, c'est l'usage parfaitement légal et quotidien des API d'IA. Et un cas tout récent, issu de la recherche de pointe, illustre ce problème avec une violence qui devrait faire dresser l'oreille à toutes les entreprises.
La situation : quand l'assistant devient le concurrent
Le problème se résume à une prémisse inconfortable. Si vous utilisez un modèle frontière hébergé (GPT, Claude ou Gemini) pour casser vos noix les plus dures, vous entraînez peut-être l'algorithme de votre fournisseur. Et donc, potentiellement, votre future concurrence.
Nous sous-traitons notre travail cognitif le plus lourd à des « boîtes noires ». Nous les nourrissons de contexte, corrigeons leurs erreurs et leur montrons le bon chemin à coups de prompts précis. Nous croyons utiliser un outil. En réalité, nous sommes le département R&D bénévole des géants de la tech.
Le scandale actuel autour du problème de Navier-Stokes montre à quel point ce mécanisme peut être impitoyable dans la pratique.
Le cas concret : l'affaire Navier-Stokes
Le problème d'existence et de régularité des solutions de Navier-Stokes n'a rien d'une niche académique. C'est l'un des sept problèmes du millénaire, et le Clay Mathematics Institute a promis un million de dollars américains à qui le résoudra. Ces équations décrivent l'écoulement des liquides et des gaz. Qui les résout entre dans l'histoire des sciences.
Le mathématicien de NYU Tristan Buckmaster et son collègue Levent Alpöge (employé chez Anthropic, mais menant ici des recherches à titre privé) y travaillaient en silence. Ils avaient choisi une voie mathématique extrêmement rare et peu conventionnelle (la tactique dite « smooth force »). Pour leurs travaux, ils utilisaient intensivement Codex, le modèle d'IA de programmation d'OpenAI.
Le 8 septembre 2026, Buckmaster publie de premières preuves prometteuses. Peu après, le choc : OpenAI annonce, sortie de nulle part, une solution complète du problème.
Ce qui rend l'affaire explosive, ce sont les détails :
- L'approche : l'IA d'OpenAI a emprunté exactement la même voie exotique et extrêmement rare que Buckmaster.
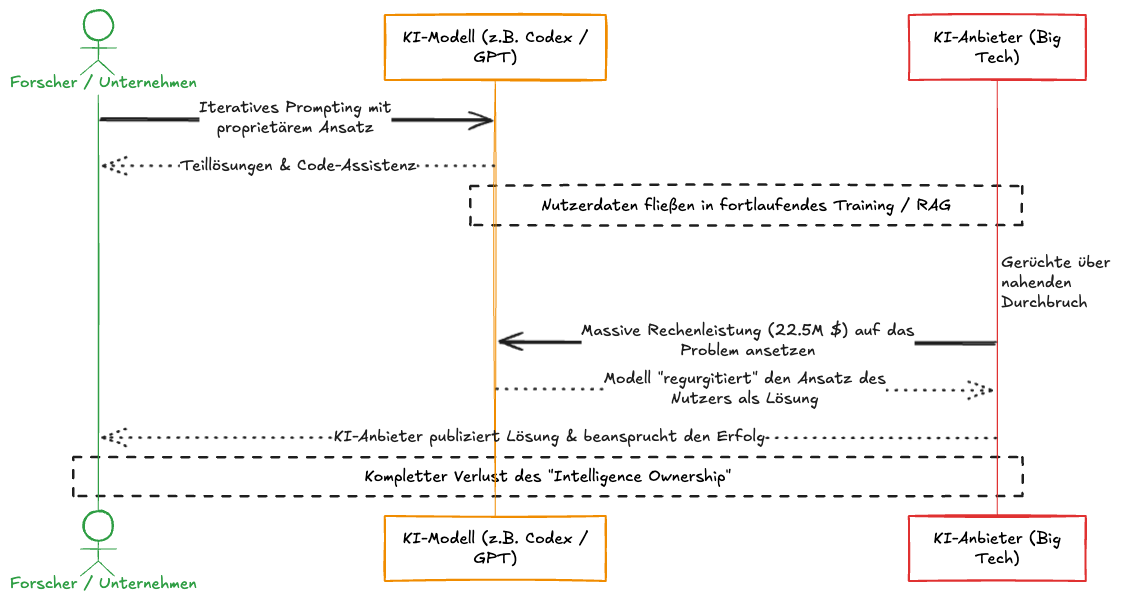
- Les ressources : OpenAI a fait tourner pendant une semaine un modèle de nouvelle génération non publié, pour 22,5 millions de dollars (300 milliards de tokens en sortie), motivée, selon l'entreprise, par des « rumeurs de marché » sur une solution imminente.
- Les manières : lorsque Buckmaster a protesté, des chercheurs d'OpenAI l'auraient, selon ses propres dires, menacé (« Pourquoi veux-tu ruiner ta carrière ? »), tout en l'invitant à retirer de la publication son collègue Alpöge (qui travaille, comme par hasard, chez le concurrent Anthropic).
OpenAI rejette les accusations : l'entreprise n'aurait jamais vu les travaux non publiés de Buckmaster ni extrait de manière ciblée des données utilisateur spécifiques. Le modèle aurait résolu le problème de façon autonome.
Analyse : l'architecture de l'expropriation
La défense d'OpenAI est peut-être même techniquement exacte. Et c'est précisément ce qui rend la situation si dangereuse. Il faut examiner ici plusieurs scénarios de diffusion du savoir propriétaire à travers les API.
Il est peu probable qu'un ingénieur d'OpenAI ait lu à la main les conversations de Buckmaster. La réalité des LLM modernes est plus subtile : les modèles apprennent à partir d'interactions utilisateur agrégées et « dé-identifiées ». Quand un chercheur brillant force un modèle, des jours durant, à suivre un chemin mathématique exotique, les poids (weights) changent en arrière-plan. Le modèle apprend le chemin. Et lorsqu'une équipe de recherche interne du fournisseur lui soumet ensuite une tâche similaire, il recrache simplement ce savoir fraîchement acquis. Ou, en jargon IA : il le régurgite.
C'est au fond le principe de l'assimilation Borg de Star Trek, coulé dans les mathématiques des réseaux de neurones : la singularité intellectuelle de l'individu est inexorablement ajoutée au Collectif.
Le diagramme de séquence ci-dessous rend visible cette relation asymétrique :
Pourquoi ce cas est si révélateur
Trois schémas méritent l'attention, parce qu'ils se généralisent :
1. L'asymétrie de la charge de la preuve. Buckmaster doit prouver que son savoir a été extrait, face à une boîte noire dont personne ne peut consulter les données d'entraînement. Le fournisseur, lui, n'a qu'à affirmer avoir travaillé de manière indépendante. Qui contrôle les weights contrôle aussi la vérité sur leur origine. C'est exactement ce que j'entendais en mars par l'opacité comme problème structurel.
2. L'asymétrie des ressources. Deux chercheurs contre 22,5 millions de dollars de compute. Dès que la direction est connue (et la direction était le véritable exploit intellectuel de Buckmaster), le reste devient un exercice de calcul. Autrement dit : aujourd'hui, la part la plus précieuse du travail intellectuel n'est plus l'exécution. C'est le jugement sur la voie qui vaut la peine d'être explorée. Exactement les « quiet judgment calls » de l'article de mars. Et exactement ce qui s'échappe par l'usage des API.
3. L'asymétrie du pouvoir. Si les témoignages sont exacts, on a suggéré à Buckmaster de rayer des crédits le nom d'un collègue (affilié à Anthropic !), le tout assaisonné de la question « Pourquoi veux-tu ruiner ta carrière ? ». (Librement traduit dans la langue du Collectif Borg : « La résistance est futile. ») Reste à voir si les choses se sont vraiment passées ainsi. Mais qu'un chercheur isolé soit structurellement en position de faiblesse face à un fournisseur dont les outils conditionnent son travail quotidien, ce n'est pas une accusation, c'est de l'arithmétique. Le vendor lock-in n'est décidément pas qu'un problème de coûts. C'est aussi un problème de pouvoir.
Pourquoi l'« Intelligence Ownership » est une question de survie
Quelle que soit l'issue juridique, cette affaire est le plan détaillé du cauchemar de toute entreprise. Remplacez « Navier-Stokes » par le design moléculaire de votre laboratoire pharmaceutique, le code source de votre startup fintech ou les stratégies contractuelles de votre cabinet d'avocats.
La conséquence de ce cas est fondamentale : votre interaction avec une IA tierce n'est pas un espace clos.
Quand vous déversez la mémoire institutionnelle de votre organisation dans les serveurs des grands fournisseurs, vous ne cédez pas seulement vos données. Vous transférez vos approches de résolution, votre créativité et votre culture de l'erreur dans un système conçu pour assimiler ce savoir, le généraliser et le mettre à disposition du reste du monde (ou des propres départements de recherche du fournisseur).
Si OpenAI a pu jeter 22,5 millions de dollars de puissance de calcul sur un problème précis, c'est uniquement parce que le travail préparatoire, le cadrage intellectuel, avait déjà goutté dans le système via l'usage de l'API par un expert externe.
Voilà pourquoi l'Intelligence Ownership n'est ni un simple buzzword informatique ni une pure question de coûts. C'est la question de principe : à qui appartient la création de valeur intellectuelle dans la société numérique du XXIe siècle ? Qui renonce au contrôle total des poids (weights) de son IA renonce, au bout du compte, à la souveraineté sur son capital le plus précieux.
La question n'est plus seulement de savoir quelle IA est la plus intelligente. La question est : si vous réalisez aujourd'hui une percée avec une IA, à qui appartiendra-t-elle demain ?