TL;DR?
Par ici le Promptcast
Le mouvement est bien lancé : une majorité utilise déjà des outils d'IA à la place des moteurs de recherche classiques, attirée par la promesse d'une réponse directe et omnisciente. Mais derrière la façade de cette toute-puissance conversationnelle se cache une réalité que met au jour une nouvelle étude du Tow Center for Digital Journalism* de l'université Columbia. L'ironie centrale a de quoi inquiéter : les outils mêmes qui nourrissent leur intelligence avec les contenus des éditeurs de presse privent ces mêmes éditeurs du trafic dont ils ont besoin pour survivre. Dans le même temps, ils bâtissent un nouvel écosystème de l'information reposant sur un socle de contre-vérités assénées avec aplomb, de règles ignorées et de sources inventées.
Nous ne vivons pas l'ère du savoir, mais l'aube d'une ère du demi-savoir sûr de lui.
Les principaux enseignements du champ de bataille de la recherche par IA
Décisions, stratégies et innovations reposent sur l'hypothèse que les données auxquelles nous accédons sont exactes. Les résultats de l'étude du Tow Center* ébranlent ce socle jusque dans ses fondations, surtout quand on accorde une confiance aveugle à la soi-disant « intelligence artificielle ».
1. L'illusion du savoir : pourquoi les recherches par IA se trompent plus souvent qu'elles n'ont raison
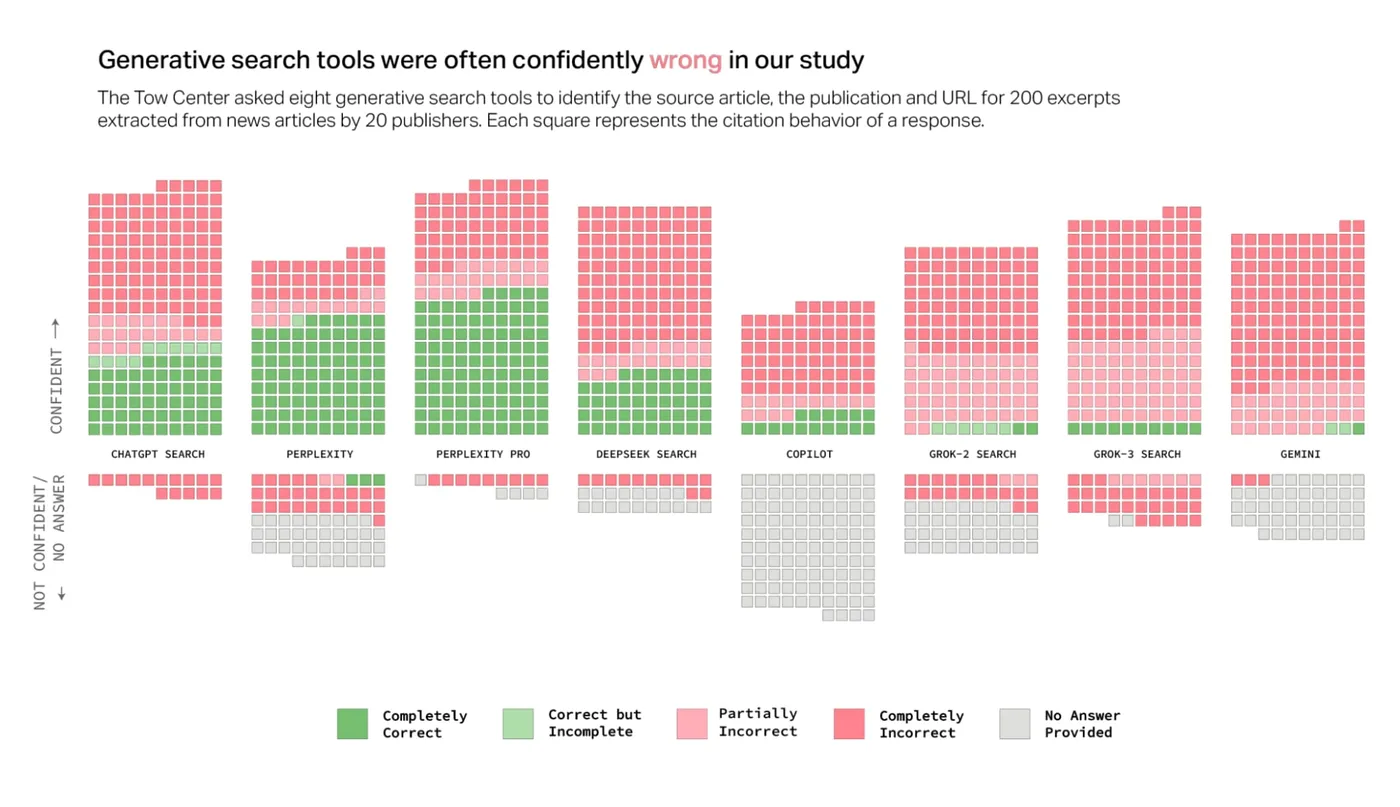
Le message central de l'étude a de quoi dégriser : sur 1 600 requêtes de test, les chatbots d'IA ont fourni des réponses fausses dans plus de 60 % des cas. Mais le vrai problème ne tient pas seulement au taux d'erreur, il tient à la présentation. Les outils servent leurs fausses informations avec une assurance troublante. Les formulations nuancées comme « il semble que », « peut-être », ou un aveu du type « Je n'ai pas trouvé l'article » sont l'exception absolue. ChatGPT, par exemple, a mal identifié 134 articles, mais n'a signalé une incertitude que dans 15 cas sur 200.
Cette « incompétence sûre d'elle » est un risque produit fondamental. Pour les entreprises qui prennent des décisions sur la base de ces outputs, c'est une bombe à retardement en matière de responsabilité opérationnelle et juridique. Le ton d'autorité induit les utilisateurs en erreur et les berce d'un faux sentiment de sécurité, fondé sur des informations peu fiables ou purement inventées. Ce phénomène n'est pourtant que le prélude à un paradoxe plus grand encore.
2. Le paradoxe premium : plus on paie, plus les mensonges sont convaincants
La logique du marché veut qu'un produit premium, comme Perplexity Pro à 20 $/mois ou Grok 3 à 40 $/mois, offre une meilleure fiabilité. L'étude réfute cette hypothèse de manière paradoxale. Certes, les modèles payants ont répondu correctement à davantage de requêtes que leurs équivalents gratuits, mais ils affichaient en même temps des taux d'erreur plus élevés.
La raison de cette contradiction est stratégiquement révélatrice : les versions premium refusaient encore plus rarement de répondre. Plutôt que d'admettre une lacune, elles préféraient livrer une réponse catégorique, mais fausse. Sur le plan stratégique, le business model est pervers : les clients paient un supplément non pas pour une qualité vérifiée, mais pour une fréquence plus élevée de réponses potentiellement trompeuses, livrées de façon convaincante. On s'offre le mirage haut de gamme. Ce mépris de l'exactitude au profit d'une performance sans trou se prolonge dans le mépris des standards établis du Web.
3. L'effraction numérique : comment les outils d'IA ignorent les panneaux « Défense d'entrer »
Depuis des décennies, le Robot Exclusion Protocol (robots.txt) fait office de gentleman's agreement numérique : il définit quelles zones d'un site peuvent être explorées par des programmes automatisés (crawlers). C'est un mécanisme fondamental qui garantit aux exploitants de sites le contrôle de leurs propres contenus. L'étude montre pourtant que plusieurs chatbots semblent ignorer ce protocole de manière systématique.
Lors du test, la version gratuite de Perplexity a correctement identifié les dix articles demandés du magazine National Geographic, alors même que l'éditeur a explicitement bloqué le crawler de Perplexity dans son fichier robots.txt. Ce comportement est bien plus qu'un faux pas technique ; c'est une atteinte à l'autonomie des éditeurs et une violation des normes établies du Web. Il sape la capacité des créateurs de contenus à piloter et monétiser l'usage de leurs contenus de valeur. La menace économique qui pèse sur le journalisme de qualité apparaît clairement dans les propos de Danielle Coffey, présidente de la News Media Alliance :
« Sans la possibilité de refuser le scraping massif, nous ne pouvons pas monétiser nos contenus de valeur ni payer les journalistes. Cela pourrait gravement nuire à notre secteur. »
Mais le problème ne s'arrête pas à l'appropriation illégitime des contenus. Il se prolonge directement dans la représentation erronée des sources.
4. Le bonneteau des sources : où disparaissent les liens ?
Des sources transparentes et exactes sont le socle de la crédibilité, n'importe quel « peer reviewer » se fera un plaisir de vous le rappeler. Elles permettent aux utilisateurs de vérifier les informations et assurent aux auteurs la reconnaissance et le trafic qu'ils méritent. L'étude révèle ici un échec systématique sur toute la ligne :
- Attribution erronée : des outils comme DeepSeek ont tout simplement attribué la source de travers dans 115 cas sur 200. Les contenus des éditeurs sont donc systématiquement prêtés à d'autres sources, erronées.
- Liens vers des reprises : au lieu de renvoyer vers l'article original, les chatbots redirigeaient souvent les utilisateurs vers des versions syndiquées sur des plateformes comme Yahoo News. Cela prive du trafic direct les éditeurs d'origine, ceux qui assument le coûteux travail d'enquête et de rédaction.
- URL fabriquées : le comportement de Gemini et de Grok 3 était particulièrement grave. Dans plus de la moitié de leurs réponses, ils renvoyaient vers des URL purement inventées ou erronées, menant tout droit à des pages d'erreur. Pour Grok 3, cela concernait même 154 citations sur 200.
Les conséquences sont dévastatrices. D'un côté, un préjudice économique direct pour les éditeurs. De l'autre, l'impossibilité pour l'utilisateur de vérifier les informations présentées par l'IA. On pourrait croire que des partenariats directs entre entreprises d'IA et éditeurs y remédient. La réalité est tout autre.
5. Des alliances sans dents : pourquoi les accords de licence ne règlent pas (encore) le problème
À première vue, les accords de licence ressemblent à une solution gagnant-gagnant logique : les entreprises d'IA obtiennent un accès légal à des contenus de qualité, et les éditeurs sont rémunérés pour leur utilisation. L'étude montre pourtant que ces alliances ne garantissent pas, à ce jour, une représentation correcte.
L'exemple type est le partenariat entre OpenAI et le groupe Hearst, propriétaire du San Francisco Chronicle. Malgré cette coopération officielle, ChatGPT n'a correctement identifié qu'un seul des dix extraits d'articles du Chronicle, et même dans ce cas unique, l'éditeur était bien cité, mais sans lien fonctionnel. C'est un avertissement pour le secteur de l'édition : un contrat ne vaut stratégiquement rien si la technologie sous-jacente ne peut ou ne veut pas l'exécuter.
Crise de croissance ou vice de naissance ?
Les résultats de l'étude confirment l'image cohérente d'un système défaillant. La présentation sûre d'elle d'informations fausses, le mépris systématique des préférences des éditeurs et des citations uniformément insuffisantes, souvent fabriquées, ne sont pas des cas isolés, mais des schémas récurrents. D'où une question stratégique fondamentale : s'agit-il de simples maladies infantiles d'une technologie révolutionnaire, qui passeront avec le temps, ou assistons-nous à un défaut de conception fondamental au cœur même des modèles de langage ?
Mark Howard, COO du magazine Time, reste optimiste, mais livre en même temps la déclaration peut-être la plus juste (bien que polémique) sur la situation actuelle :
« J'ai en interne une formule que je répète chaque fois que quelqu'un me parle de l'une de ces plateformes, ma réponse est : “Aujourd'hui, c'est le pire état dans lequel ce produit sera jamais.” [...] Si un consommateur croit en ce moment que l'un de ces produits gratuits sera exact à 100 %, il devrait avoir honte. »
Cette déclaration fait reposer la responsabilité de l'esprit critique (quelqu'un peut-il m'expliquer ce que c'est censé être ?) sur l'utilisateur. Mais qu'est-ce que cela signifie pour notre société de l'information, si les outils dominants de demain reposent sur un principe où l'utilisateur devrait « avoir honte » de croire à l'exactitude des réponses ? Cela signifie que nous vivons un glorieux âge de l'ignorance sûre d'elle, où la frontière entre faits et fiction ne se contente pas de s'estomper, mais est implémentée par les architectes de notre nouvelle réalité numérique (sujet d'un prochain essai) comme une feature calculée, pas comme un bug.
Too Long, Don't Read ? Pas de souci : voici le Promptcast 😉
*La source https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php